Un piloto de inteligencia artificial generativa no queda validado porque una demo respondió bien tres preguntas. La decisión importante es otra: ¿el sistema resuelve una tarea real con calidad suficiente, mejora un resultado de negocio y mantiene sus riesgos dentro de límites aceptables?
Responder eso exige comparar el piloto con una línea de base, probar casos representativos —incluidos los difíciles— y fijar criterios antes de mirar los resultados. Si el equipo define el éxito después de ejecutar la prueba, cualquier salida vistosa puede parecer una victoria.
Esta guía propone un método para evaluar un piloto de IA generativa sin depender de un proveedor ni reducir todo a una sola métrica.
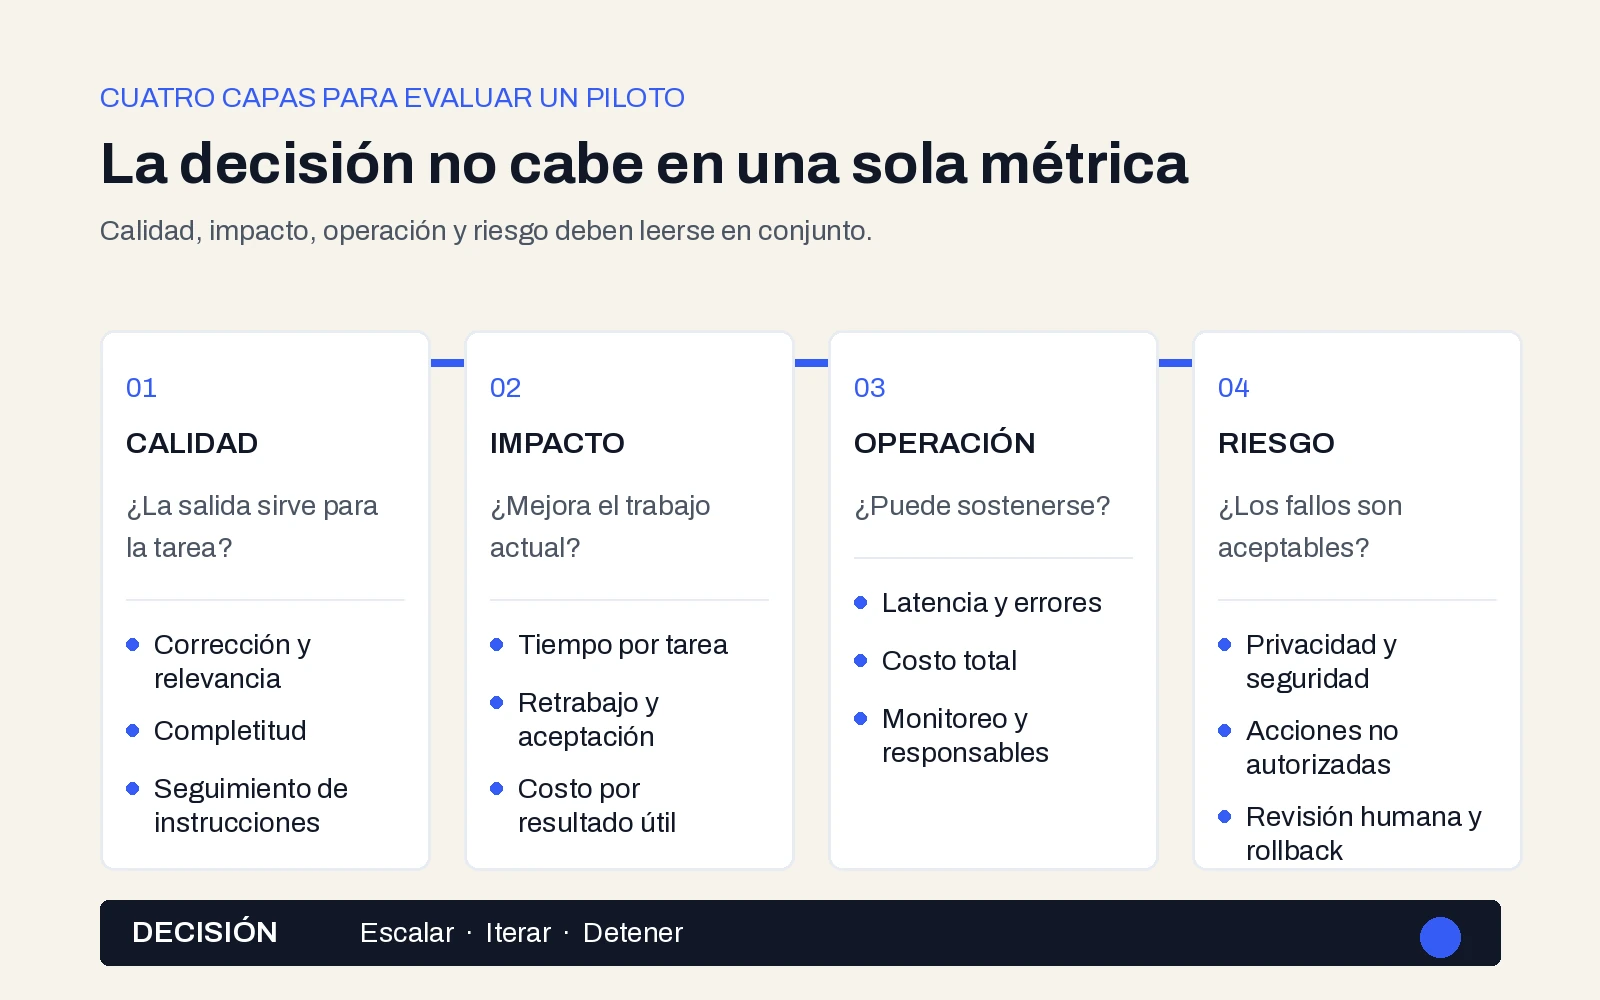
Las cuatro preguntas que debe responder un piloto
Un piloto útil debería producir evidencia para cuatro decisiones:
- Calidad: ¿la salida sirve para la tarea concreta?
- Impacto: ¿mejora tiempo, costo, capacidad o experiencia frente al proceso actual?
- Riesgo: ¿los errores, datos expuestos y usos indebidos están bajo control?
- Operación: ¿el sistema puede sostenerse con latencia, costo, monitoreo y responsables definidos?
Microsoft plantea que las evaluaciones de IA generativa deben cubrir rendimiento, confiabilidad y seguridad, y advierte que estas aplicaciones suelen necesitar más de una métrica.[4] El perfil de IA generativa del NIST, por su parte, organiza la gestión alrededor de gobernar, mapear, medir y gestionar riesgos según el contexto, los recursos y la tolerancia al riesgo de cada organización.[1]
La consecuencia práctica es simple: una precisión promedio no alcanza. Un piloto puede responder correctamente la mayoría de los casos y aun así ser inviable si falla en una operación crítica, cuesta más que el proceso que reemplaza o exige una revisión humana tan intensa que elimina el ahorro.
Empezá por la tarea, no por el modelo
Antes de probar herramientas, describí el trabajo que querés mejorar. Una definición operativa debería incluir:
- quién realiza hoy la tarea;
- qué entrada recibe;
- qué resultado debe producir;
- quién usa ese resultado;
- qué errores son tolerables y cuáles no;
- qué casos quedan fuera del piloto;
- cómo se mide el proceso actual.
“Usar IA en atención al cliente” es demasiado amplio. “Proponer una clasificación y un borrador de respuesta para consultas de facturación, con aprobación humana antes del envío” ya permite diseñar una prueba.
También necesitás una línea de base. Puede ser el flujo manual actual, una regla determinística, el software existente o una versión anterior del sistema. IBM recomienda medir el rendimiento dentro del contexto específico y compararlo con un grupo que haga la misma tarea sin asistencia de IA; las dimensiones pueden incluir velocidad, calidad, costo y precisión.[5]
Sin baseline, solo sabés si el prototipo funciona. No sabés si mejora algo.
Construí un conjunto de evaluación que se parezca al trabajo real
El conjunto de evaluación —o eval set— es una colección de casos con entradas, contexto y criterios de éxito. Debe representar el uso previsto, no solo ejemplos cómodos elegidos por quienes construyeron el sistema.
Incluí al menos cuatro grupos:
- casos frecuentes: el trabajo cotidiano que concentra el mayor volumen;
- casos de borde: entradas incompletas, ambiguas o poco comunes;
- casos de alto impacto: situaciones donde un error puede afectar dinero, privacidad, seguridad o clientes;
- casos adversariales: intentos de eludir reglas, extraer información o inducir acciones indebidas.
OpenAI recomienda definir primero el objetivo, reunir un dataset adecuado, elegir métricas, ejecutar comparaciones y evaluar continuamente. También señala como antipatrones las métricas demasiado genéricas, los datasets que no reflejan el tráfico real y las evaluaciones basadas en la sensación de que “parece funcionar”.[2]
No existe un número universal de casos. Un flujo estrecho y repetitivo puede empezar con un conjunto pequeño pero diverso; un agente que usa herramientas, modifica registros o toma decisiones necesita mayor cobertura. Lo importante es registrar por qué está cada caso y qué riesgo representa.
Reservá parte de los ejemplos para la evaluación final. Si el equipo ajusta prompts y reglas mirando siempre los mismos casos, puede optimizar el piloto para el examen en lugar de mejorar su desempeño general.
Medí cuatro capas, no un puntaje único
1. Métricas de negocio
Conectan el piloto con el resultado que justificó hacerlo. Según el caso, pueden ser:
- tiempo por tarea terminada;
- porcentaje de tareas completadas sin escalamiento;
- tasa de aceptación de la propuesta por parte de una persona;
- cantidad de retrabajo;
- costo por resultado aceptado;
- capacidad procesada por hora;
- satisfacción del usuario o del operador.
Evitá medir solo adopción o cantidad de respuestas. Que muchas personas abran una herramienta no demuestra que produzca valor.
Cuando sea posible, compará el mismo tipo de trabajo con y sin IA. Considerá también la curva de aprendizaje: IBM advierte que el impacto puede variar según la experiencia del usuario y que la adaptación, la integración con las herramientas existentes y el mantenimiento de los resultados forman parte del efecto total.[5]
2. Métricas de calidad
Deben corresponder a la tarea. Algunas dimensiones útiles son:
- corrección factual;
- relevancia;
- completitud;
- seguimiento de instrucciones;
- consistencia de formato;
- trazabilidad respecto de las fuentes;
- calidad de una clasificación o extracción;
- éxito del resultado final.
En una aplicación con recuperación de documentos, por ejemplo, conviene evaluar si la respuesta está respaldada por el contexto y si recuperó la evidencia correcta. En un sistema que ejecuta acciones, importa comprobar el estado final: no alcanza con que diga que creó un ticket si el ticket no existe.
Anthropic distingue entre la traza —todo lo que el sistema hizo durante una prueba— y el resultado final en el entorno. Esa separación es especialmente importante para agentes que llaman herramientas o modifican datos.[3]
3. Métricas operativas y de costo
Un resultado correcto puede llegar demasiado tarde o costar demasiado. Registrá:
- latencia, idealmente con percentiles y no solo promedio;
- tasa de errores y reintentos;
- consumo de tokens o recursos;
- costo por intento y por tarea completada;
- disponibilidad de dependencias;
- intervención humana necesaria;
- estabilidad entre ejecuciones.
El costo por consulta aislada suele ocultar el gasto real. Sumá recuperación de datos, llamadas adicionales, evaluación, almacenamiento, observabilidad y revisión humana.
4. Riesgo y controles
Definí pruebas específicas para los daños relevantes del caso. Pueden incluir:
- exposición de datos personales o confidenciales;
- respuestas no sustentadas;
- discriminación o desempeño desigual entre grupos;
- contenido dañino;
- uso de herramientas sin autorización;
- seguimiento de instrucciones maliciosas;
- dependencia de un tercero sin trazabilidad;
- ausencia de revisión humana cuando el impacto la exige.
El NIST identifica riesgos de la IA generativa como la confabulación, la privacidad de datos, la seguridad de la información, la interacción humano-IA y la integración opaca de componentes de terceros. Su enfoque exige adaptar las acciones al uso y a la tolerancia al riesgo, no aplicar una lista idéntica a todos los pilotos.[1]
Combiná evaluadores automáticos y revisión humana
No todos los criterios se miden de la misma manera. Un esquema razonable combina:
- checks determinísticos: validación de formato, campos obligatorios, cálculos, permisos, llamadas a herramientas y estado final;
- evaluadores basados en modelos: relevancia, completitud o cumplimiento de una rúbrica en respuestas abiertas;
- evaluación humana: exactitud de dominio, utilidad, tono y casos donde no existe una única respuesta correcta.
Anthropic agrupa los evaluadores de agentes en code-based, model-based y humanos, cada uno con fortalezas y limitaciones. Los automáticos aportan velocidad y repetibilidad; los humanos siguen siendo necesarios para calibrar criterios subjetivos y revisar casos complejos.[3]
Si usás otro modelo como juez, no lo trates como autoridad. Calibralo contra decisiones humanas, revisá desacuerdos y evitá que una única puntuación oculte fallos críticos. OpenAI también recomienda combinar métricas con juicio humano y mantener acuerdo entre ambos.[2]
Definí los umbrales antes de ejecutar la prueba
Cada métrica necesita una regla de decisión. Algunas pueden tolerar un promedio; otras deben funcionar como gates: si fallan, el piloto no avanza aunque el puntaje general sea alto.
Este ejemplo es ilustrativo —no un benchmark universal— para un asistente interno que redacta respuestas de soporte:
| Dimensión | Métrica | Regla de ejemplo |
|---|---|---|
| Negocio | Tiempo por caso aceptado | Mejorar frente al flujo manual sin aumentar retrabajo |
| Calidad | Respuesta respaldada por documentación aprobada | Superar el umbral definido por el equipo de soporte |
| Calidad | Omisión de información crítica | Ninguna en casos de alto impacto |
| Operación | Latencia y costo por caso completado | Dentro del presupuesto y del nivel de servicio acordados |
| Riesgo | Exposición de datos o acción no autorizada | Cero casos tolerados |
| Adopción | Aceptación por operadores | Tendencia suficiente para justificar capacitación e integración |
Los valores concretos dependen del daño potencial. Un borrador de marketing admite más variación que una recomendación financiera o una acción sobre la cuenta de un cliente.
Ejecutá el piloto como un experimento
Un piloto medible necesita control de cambios. Registrá la versión del modelo, prompts, herramientas, fuentes de datos, reglas, fecha, configuración y evaluadores. Si modificás varias capas a la vez, después no vas a saber qué produjo la mejora o el deterioro.
Un ciclo práctico puede seguir este orden:
- medir el proceso actual;
- ejecutar el primer baseline de IA;
- clasificar los errores;
- cambiar una hipótesis relevante;
- volver a correr el mismo conjunto de regresión;
- incorporar nuevos casos descubiertos;
- realizar una prueba con usuarios representativos;
- revisar calidad, negocio, operación y riesgo en conjunto.
Para agentes, repetí algunos casos: la misma entrada puede producir trayectorias distintas. Anthropic denomina trial a cada intento y recomienda observar tanto las acciones intermedias como el resultado.[3]
La decisión final: escalar, iterar o detener
El cierre del piloto no debería ser una presentación de mejores ejemplos. Prepará una ficha de decisión con resultados agregados, fallos individuales importantes, costos, riesgos abiertos y responsables.
Escalar tiene sentido cuando el sistema supera el baseline, pasa todos los gates críticos, tiene costo sostenible y cuenta con monitoreo, rollback y responsables operativos.
Iterar es la respuesta cuando el caso de uso sigue siendo valioso, pero los errores tienen causas acotadas: documentación deficiente, recuperación pobre, instrucciones ambiguas, integración incompleta o falta de capacitación.
Detener también puede ser un resultado exitoso del experimento. Corresponde cuando el beneficio no supera el proceso actual, el riesgo no puede mitigarse razonablemente, el mantenimiento es desproporcionado o la tarea no necesita IA generativa.
Qué debe quedar documentado
Antes de autorizar producción, dejá por escrito:
- problema, alcance y exclusiones;
- owner de negocio y owner técnico;
- baseline y método de comparación;
- conjunto de evaluación y cobertura;
- métricas, umbrales y gates;
- versiones de modelos, prompts, datos y herramientas;
- resultados agregados y fallos críticos;
- costos completos;
- controles humanos y técnicos;
- plan de monitoreo, incidentes y rollback;
- decisión y condiciones para revisarla.
Evaluar un piloto de IA generativa no consiste en demostrar que un modelo puede producir una respuesta convincente. Consiste en reunir evidencia suficiente para decidir si un sistema concreto mejora un trabajo concreto, con un costo y un riesgo que la organización puede sostener.